Veraltete Statistiken: Warum der Query Optimizer falsche Entscheidungen trifft (und wie Sie es beheben)

Das Navigationssystem Ihrer Datenbank
Stellen Sie sich vor, Sie nutzen ein Navigationssystem, dessen Kartenmaterial seit fünf Jahren nicht aktualisiert wurde. Das Navi führt Sie über verstopfte Landstraßen, weil es die neue Autobahn schlicht nicht kennt.
Genau das passiert im Herzen von PostgreSQL: Der Query Optimizer entscheidet bei jeder eingehenden SQL-Abfrage anhand von internen Statistiken (gespeichert in pg_statistic), welcher Ausführungsplan (Execution Plan) der schnellste ist. Sind diese Daten veraltet – etwa nach massiven Datenimporten, Löschaktionen oder Batch-Jobs –, schätzt der Optimizer die Anzahl der zu erwartenden Zeilen (Cardinality Estimation) völlig falsch ein.
Die Konsequenz: Die Datenbank wählt langsame Sequential Scans statt gezielter Index Scans oder entscheidet sich für falsche Join-Operatoren.
Live-Szenario in AdventureWorks
Nehmen wir an, wir arbeiten in der Tabelle sales.salesorderdetail. Wir simulieren einen massiven Datenimport (z. B. durch ein nächtliches ETL-Skript) und deaktivieren für die Demonstration das automatische Update der Statistiken.
Schritt 1: Ausgangslage prüfen
Wir suchen nach Auftragspositionen mit einer überdurchschnittlich hohen Bestellmenge (orderqty > 50).
EXPLAIN ANALYZE
SELECT salesorderid, salesorderdetailid, productid, orderqty
FROM sales.salesorderdetail
WHERE orderqty > 50;
Beobachtung im Execution Plan:
Der Optimizer schätzt die Zeilenanzahl (rows=...) nahezu identisch mit der tatsächlich gelieferten Anzahl (actual rows=...). Der Plan läuft optimal.
Schritt 2: Massen-Insert & deaktivierter Auto-Analyze
Nun fügen wir 100.000 neue Test-Datensätze mit hoher Bestellmenge ein, ohne dass PostgreSQL seine Statistiken sofort aktualisiert:
-- Deaktivieren der automatischen Analyse für die Tabelle (nur zur Demonstration)
ALTER TABLE sales.salesorderdetail SET (autovacuum_enabled = false);

-- Simulierter Massen-Import von Testdaten
INSERT INTO sales.salesorderdetail (salesorderid, orderqty, productid, specialofferid, unitprice, unitpricediscount)
SELECT
    1000 + (g % 5000),
    99, -- Sehr hohe Bestellmenge
    1,
    1,
    10.00,
    0.00
FROM generate_series(1, 100000) AS g;
Schritt 3: Die Katastrophe im Ausführungsplan
Wenn wir die identische Abfrage nun erneut ausführen:
EXPLAIN ANALYZE
SELECT salesorderid, salesorderdetailid, productid, orderqty
FROM sales.salesorderdetail
WHERE orderqty > 50;
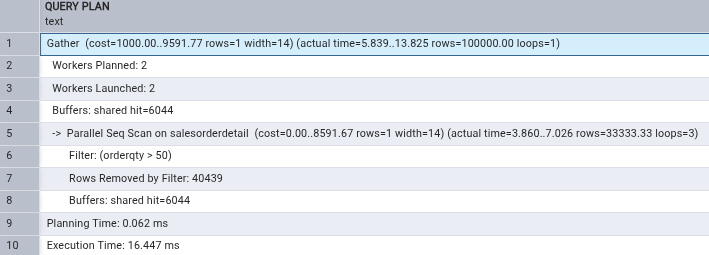
Das Problem im Output:
-
rows=1(Schätzung): Der Optimizer greift auf das veraltete Histogramm vor dem Import zurück und erwartet nur eine Handvoll Treffer. -
actual rows=100000(Realität): Es werden über 100.000 Zeilen zurückgeliefert! -
Die Auswirkung: Aufgrund der extremen falschen Schätzung wählt Postgres z. B. einen Index Scan mit anschließenden 100.000 Einzelzugriffen auf die Datenseiten, anstatt direkt einen effizienten Sequential Scan oder Parallel Scan durchzuführen. Die Abfragezeit schnellt drastisch in die Höhe.
Die Diagnose: Wie spürt man veraltete Statistiken auf?
In PostgreSQL können Sie gezielt abfragen, wann eine Tabelle zuletzt analysiert wurde und wie stark die Abweichung der Daten ist:
SELECT
    schemaname,
    relname AS tabellenname,
    n_mod_since_analyze, -- Anzahl geänderter Zeilen seit dem letzten ANALYZE
    last_analyze,        -- Manuelles ANALYZE
    last_autoanalyze     -- Automatisches ANALYZE durch Autovacuum
FROM pg_stat_user_tables
WHERE relname = 'salesorderdetail';

Wenn n_mod_since_analyze im Vergleich zur Gesamtzahl der Zeilen sehr hoch ist, läuft der Optimizer auf veralteten Annahmen.
Die Lösung: So halten Sie Statistiken frisch
1. Das Sofortmittel: Manuelles ANALYZE
Nach großen Batch-Jobs, Datenimporten oder Index-Neubauten sollte in Scripts explizit ein ANALYZE aufgerufen werden:
-- Aktualisiert sofort die Histogramme der Tabelle
ANALYZE sales.salesorderdetail;
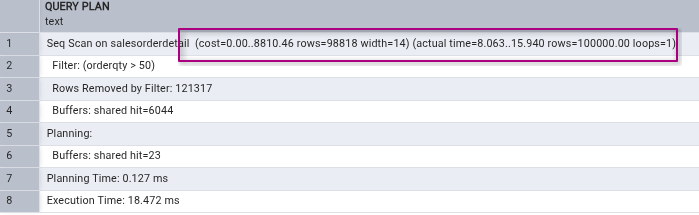
Führen Sie die Abfrage danach erneut aus: Die geschätzten Zeilen (rows) stimmen wieder mit den (actual rows) überein, und der Execution Plan wechselt auf die schnellste Strategie.
2. Autovacuum / Autoanalyze feintunen
PostgreSQL führt ANALYZE über den Autovacuum-Daemon automatisch aus. Der Standard-Schwellenwert greift, wenn sich ca. 10 % der Zeilen geändert haben (autovacuum_analyze_scale_factor = 0.1).
Bei sehr großen Tabellen (z. B. 50 Millionen Zeilen) sind 10 % jedoch 5 Millionen Änderungen – der Autoanalyze würde viel zu spät anspringen.
Empfehlenswerte Anpassung für Großtabellen:
-- Greift bereits nach 50.000 geänderten Zeilen, unabhängig von der Tabellengröße
ALTER TABLE sales.salesorderdetail SET (
    autovacuum_analyze_scale_factor = 0,
    autovacuum_analyze_threshold = 50000
);
Fazit & Best Practice
Veraltete Statistiken sind eine der häufigsten Ursachen für plötzlich einbrechende Datenbank-Performance.
-
Große ETL-Projekte: Bauen Sie am Ende von Import-Skripten immer ein explizites
ANALYZEein. -
Großtabellen anpassen: Senken Sie den
autovacuum_analyze_scale_factorfür Tabellen mit Millionen Einträgen. -
Monitoring nutzen: Überwachen Sie
pg_stat_user_tables.n_mod_since_analyze, um blinde Flecken frühzeitig zu erkennen.
Sie möchten Performance-Engpässe wie veraltete Statistiken in Ihrer eigenen Infrastruktur systematisch aufspüren und beheben? In unserer praxisnahen PostgreSQL Schulung in Hannover lernen Sie professionelles Performance-Tuning und Admin-Handwerk direkt an realen Enterprise-Szenarien.
When you subscribe to the blog, we will send you an e-mail when there are new updates on the site so you wouldn't miss them.
Comments